按行数拆分大型文本文件
选择分块大小,保留完整记录,并使用 Sort 验证拆分输出。
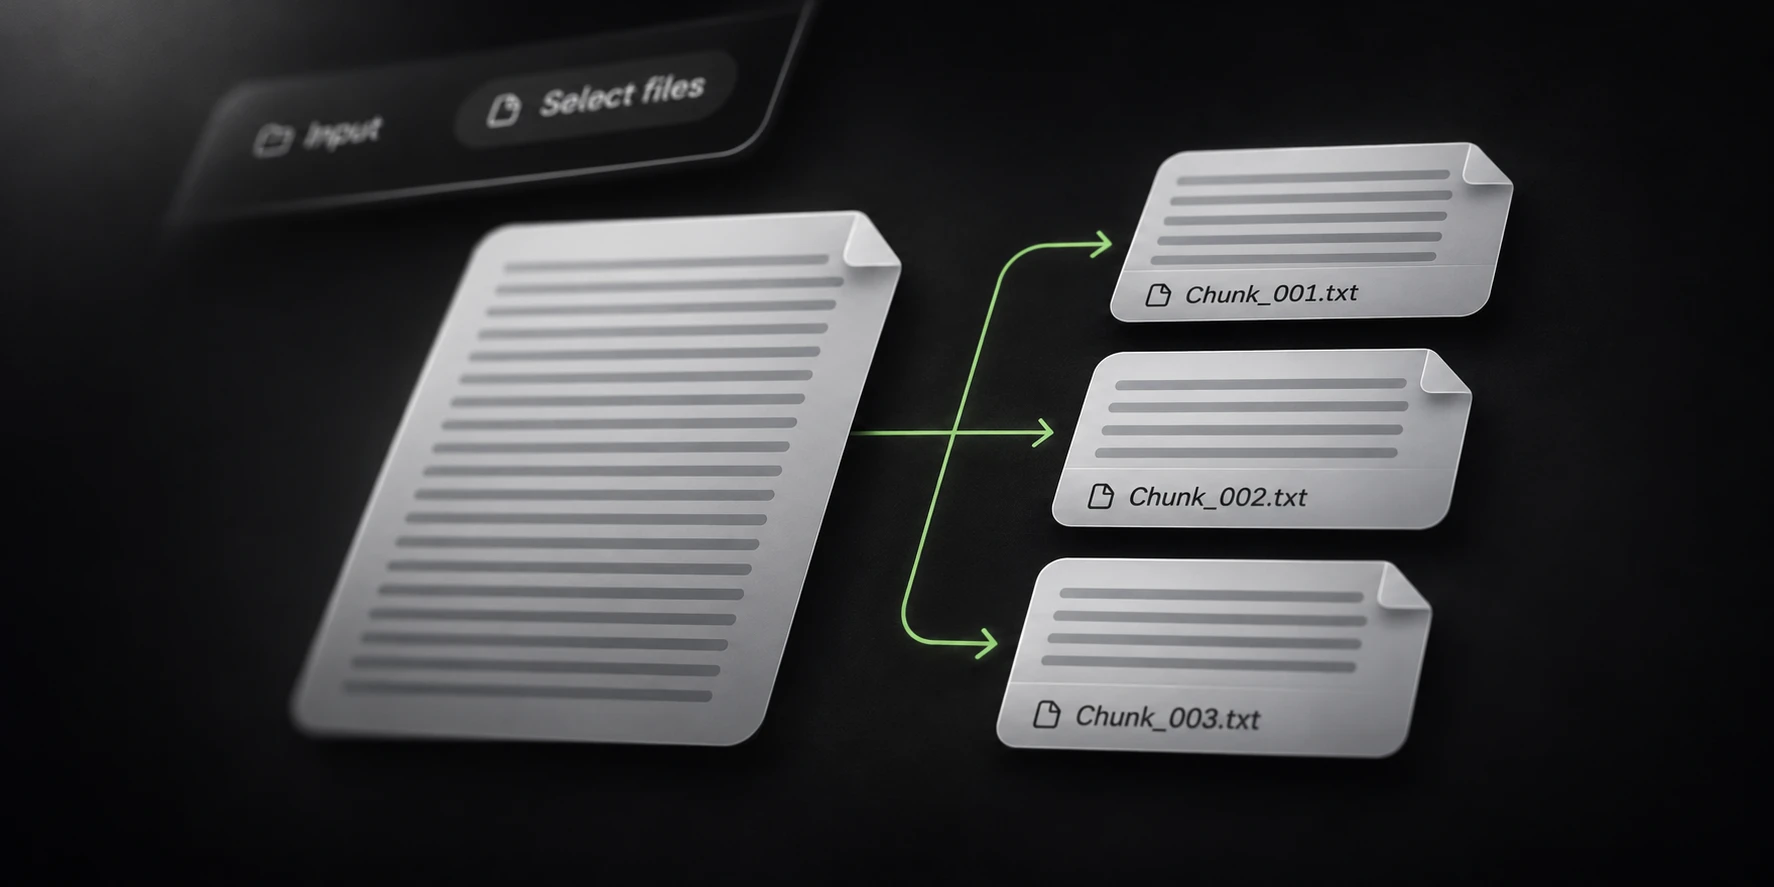
如果下一个应用需要更小的输入,可以拆分大型文本文件。 根据该应用的实际限制选择每个分块的行数, 并验证拆分操作是否保留了需要的记录。
Sort 的 Splitter 提供按行数拆分模式。 默认每块 500,000 行,前缀为 Chunk。 这只是初始设置,不代表所有下游工具都接受这一规模。
根据下游工具选择分块大小
行数限制和字节大小限制回答的是不同问题。 行长度变化时,相同行数可能产生大小相差很大的文件。
如果下游工具有字节上限,请使用有代表性的记录测试, 并在上限以下预留空间。不要用包含 500,000 条短记录的分块, 推断长记录分块的大小。
运行完整输入之前,记录所选模式、分块大小、输出文件夹和前缀。 将原始来源与拆分输出分开保存。
确定是否需要保留重复行。拆分只是将输入组织为多个部分; 只有计划中的工作流程需要删除重复记录时,才另行执行去重操作。
测试分块边界是否保留完整行
使用一个包含七条不同记录的小型生成文件,选择每块三行:
row-1
row-2
row-3
row-4
row-5
row-6
row-7
预期得到三个部分,分别包含三行、三行和一行源记录。 检查每部分的第一行和最后一行,以便发现分块边界处的遗漏或重复。
在自己的测试中加入一条有代表性的长记录。 有意义的验证条件是边界处记录完整,而不是各输出文件大小相近。
如果只需普通拆分,请将可选水印留空。 启用输出自定义时,应先单独评估,再将输出记录与源记录进行比较。
检查所有分块和完成状态
样本符合预期后,选择完整文件和具有足够可用空间的本地目标位置。 等输出保存完成,再在下一个应用中打开这些分块。
使用默认前缀时,输出从 Chunk_001.txt 开始。
将命名与操作背景一同记录,避免把不同运行产生的分块误认成同一次完整结果。
核对已完成的总行数与所选源输入,并抽查有代表性的边界。 中断的运行可能已经生成可用分块,但仍未覆盖完整输入。
之后需要重新合并时,请查看 Joiner 指南; 下游只需要明确子集时,请查看 Filter 指南。 在下游工作得到验证之前,保留源文件。