合并大型文本文件并删除重复行
使用 Sort 合并内容重叠的文本文件,选择是否去重,并验证保存的输出。
合并大型文本文件与删除重复行,是两个独立选择。 有时需要保留每个输入中的每次出现,有时则希望每种不同记录只保留一次。 运行 Joiner 之前,先确定下一个工作流程需要哪种结果。
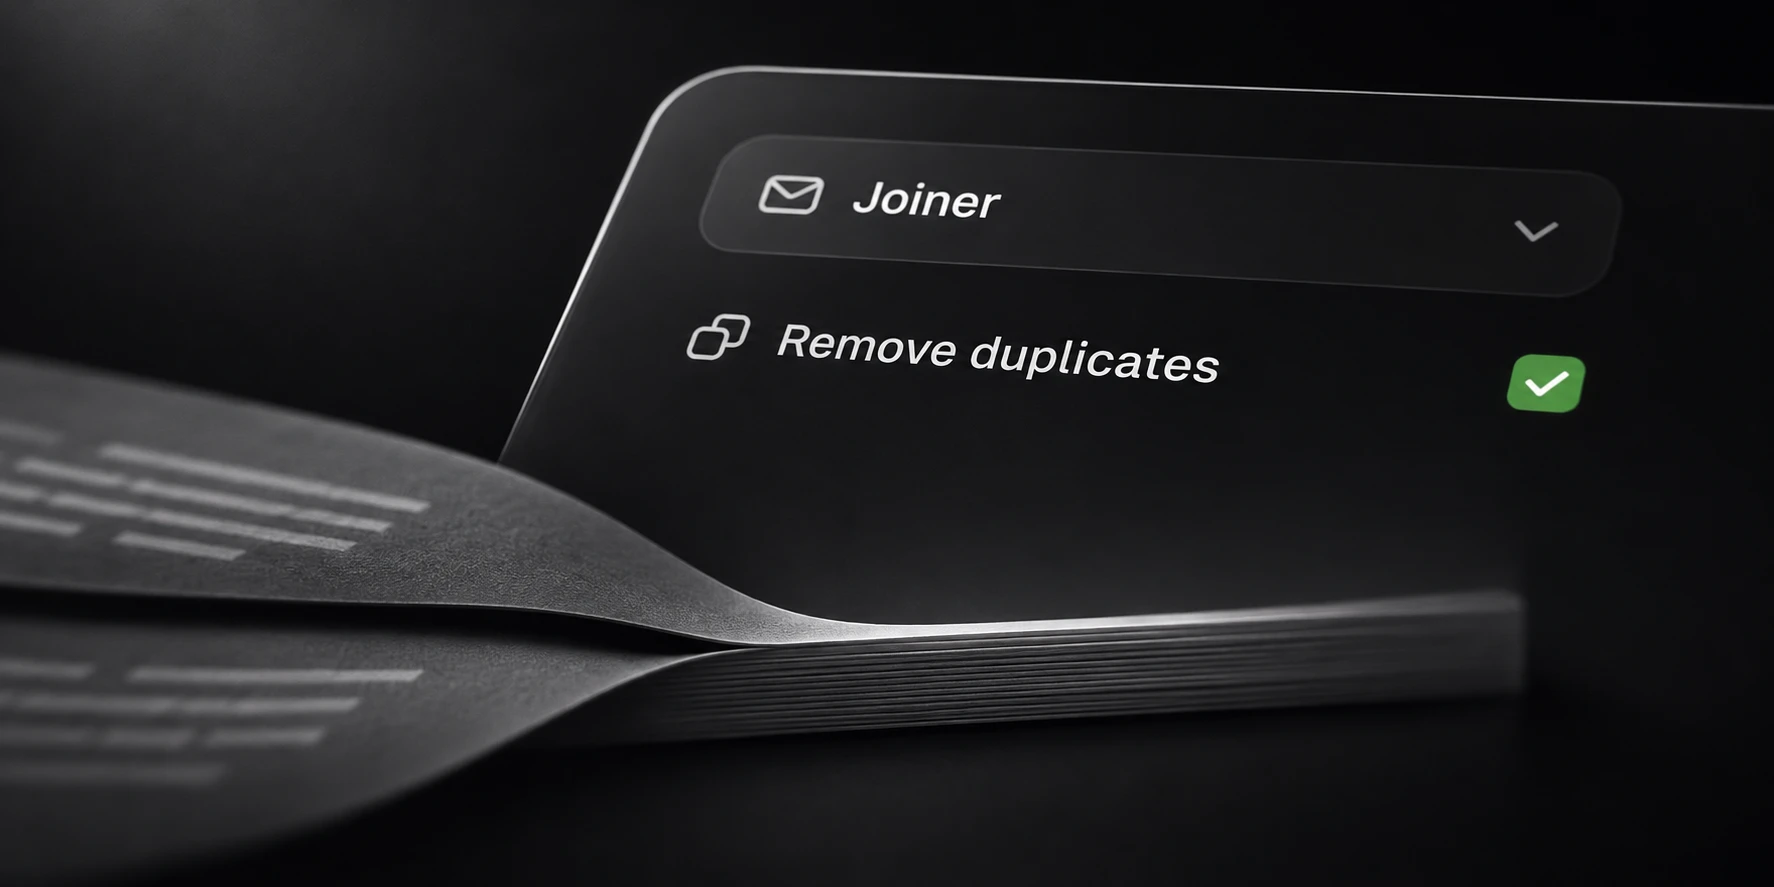
Sort 的 Joiner 会合并选中的本地文件,默认启用去重。 输出为独立文件,因此可以先检查结果,再将其用于其他地方。
准备输入文件
选择记录格式兼容的输入。将互不相关的记录类型合并, 可能得到一个无法被下游解析器一致解释的文件。
初次检查时,使用两个简短的示例文件:
first.txt
alpha
beta

second.txt
beta
gamma
此示例共有四条输入记录,包含三个不同的值。 这里描述的是两个输入文件,并不是把文件名本身也当作数据的文件格式。
检查实际源文件中的换行符和文本编码。 选择大量文件之前,先测试有代表性的文件。 如果记录包含标题,合并文件本身不会让该标题自动适合下一个工具。
选择是否删除重复内容
开启去重后,样本中重复的 beta 行只保留一次。 关闭去重时,两次出现都应进入输出。 这两种选择都不能证明输入数据有效,只是定义如何处理重复记录。
如果重复次数本身包含信息,应保留重复记录。 例如,之后的统计可能需要保留每次观察结果。 如果下一步要处理不同记录组成的集合,则可以删除重复内容。
不要将外观相似的记录自动视为等价。 大小写和字节差异可能具有意义。 检查所选比较行为时,应使用包含已知变体的样本。
如果只有一个源文件,Deduper 可能是更直接的选择。 如果合并后的文件对下一个应用过大,请在检查合并结果后,另行安排 Splitter 操作。
验证合并后的输出
选择 Joiner,添加输入,并选择本地输出文件夹。 点击 Execute 前检查去重设置。确保能清楚区分源文件与输出位置。
Joiner 会写入 joined.txt。对于上述样本,
开启去重时应保存三行,关闭时应保存四行。
扩大规模之前,既要检查计数,也要检查实际记录值。
大规模运行受存储、唯一行数、行长度和配置缓冲区影响。 不要根据较小样本或峰值进度速度推断完成时间。 将文件交给其他应用前,等待处理和输出保存全部完成。
停止运行可能意味着只有部分合并输入被处理。 请将完成状态与保存的输出一同保留。 部分文件内容有效,并不证明所有选中的输入都已经读取完毕。
Sort 文档列出了各模块的默认设置和输出文件名。 将 Joiner 与清理、筛选或拆分结合使用时, 请参照该文档,并验证每个阶段是否产生了预期效果。