Разделение больших текстовых файлов по числу строк
Выбирайте размеры частей, сохраняйте целые строки и проверяйте результат разделения в Sort.
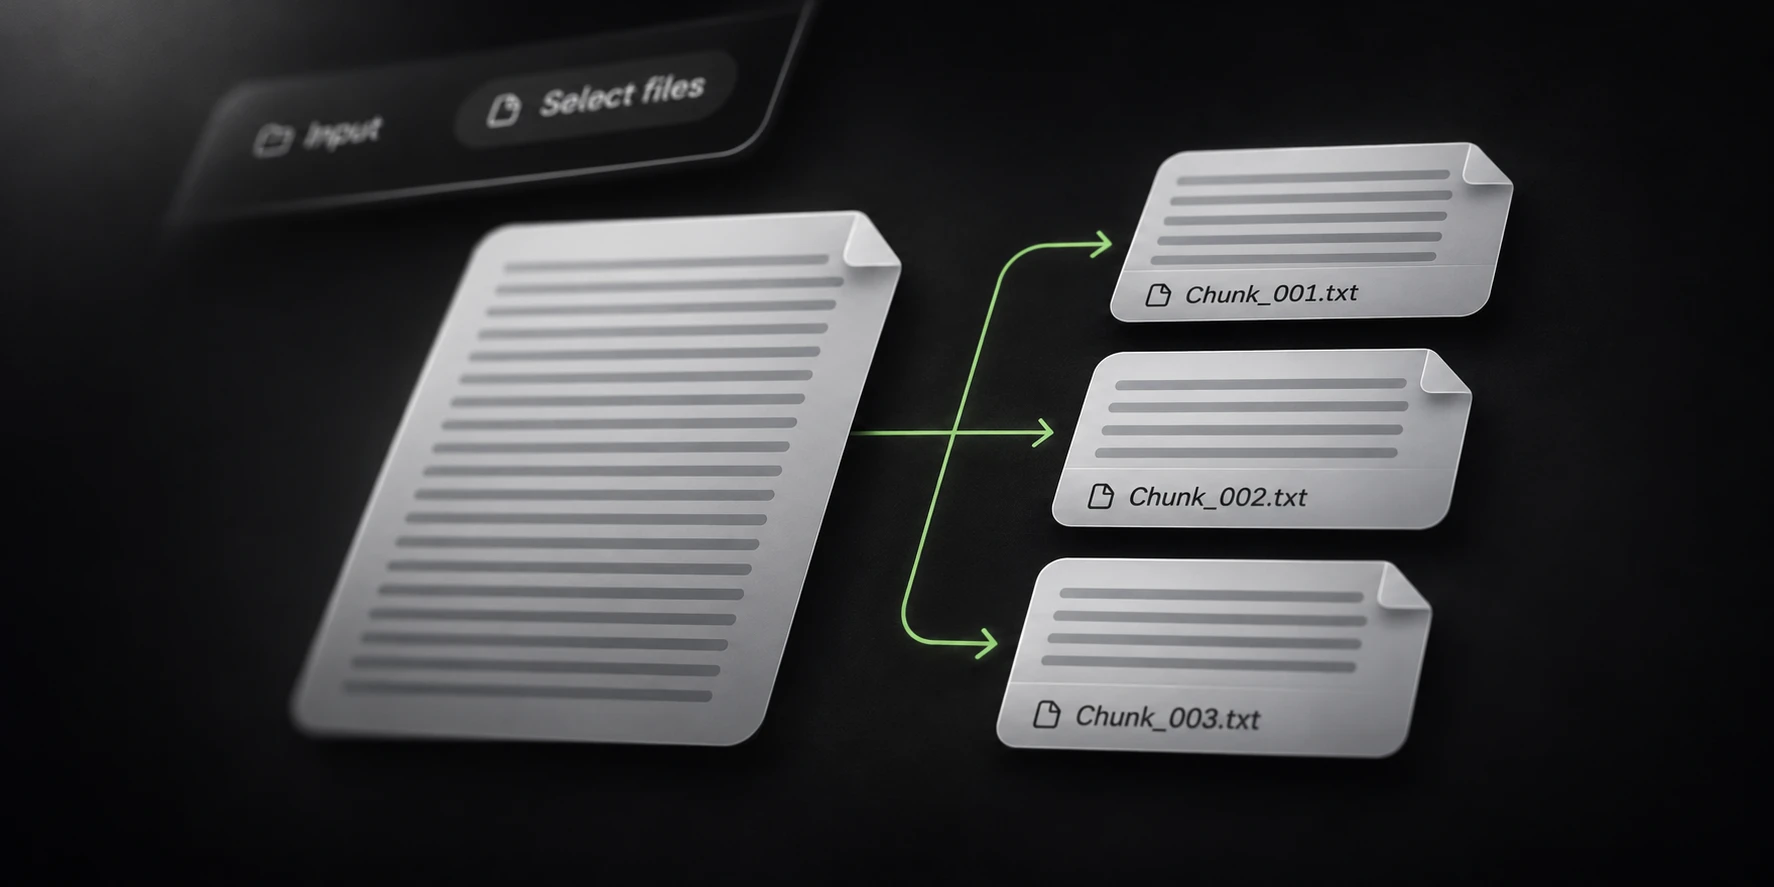
Разделяйте большой текстовый файл, когда следующей программе нужны меньшие источники. Выбирайте число строк на часть с учётом её практического предела, затем проверяйте, что разделение сохраняет нужные записи.
В Splitter в Sort есть режим по числу строк. По умолчанию используется 500 000 строк на часть и префикс Chunk. Это начальная настройка, а не предел, подходящий любой программе.
Подберите части для следующей программы
Ограничения по числу строк и по байтам решают разные задачи. Одинаковое число строк может давать сильно различающиеся размеры файлов при разной длине записей.
Если следующая программа ограничивает байты, проверьте типичные строки и оставьте запас до предела. Часть из 500 000 коротких строк не предсказывает размер части с длинными записями.
Перед полной обработкой запишите режим, размер частей, папку вывода и префикс. Храните исходник отдельно от разделённого результата.
Решите, должны ли оставаться повторы. Разделение организует входные данные по частям; отдельное удаление дублей нужно лишь тогда, когда оно входит в планируемый процесс.
Проверьте границы целых строк
Создайте небольшой файл с семью различными строками и выберите три строки на часть:
row-1
row-2
row-3
row-4
row-5
row-6
row-7
Ожидаются три части с тремя, тремя и одной исходной строкой. Проверьте первые и последние строки каждой части, чтобы заметить потерю или повтор на границе.
Добавьте в собственный тест типичную длинную строку. Важно сохранение целой записи на границе, а не внешне похожие размеры выходных файлов.
Для обычного разделения оставьте дополнительный водяной знак пустым. Если включаете оформление вывода, оцените его отдельно перед сравнением строк с источником.
Проверьте все части и завершение
Когда выборка работает ожидаемо, выберите полный файл и локальную папку с достаточным свободным местом. Дождитесь завершения записи, прежде чем открывать части следующей программой.
При стандартном префиксе имена начинаются с Chunk_001.txt. Сохраняйте имена вместе
с контекстом операции, чтобы не принять части разных запусков за один завершённый результат.
Сопоставьте итоговое число строк с выбранным источником и проверьте типичные границы. Прерванный запуск может создать полезные части, не охватив весь входной файл.
Для последующего объединения частей используйте статью о Joiner, а для выбора нужного подмножества — статью о Filter. Сохраняйте исходник до проверки следующего этапа.