Фильтрация больших текстовых файлов: текст и регулярные выражения
Выберите правило совпадения, проверьте положительные и отрицательные примеры и просмотрите совпавшие и несовпавшие строки.
Полезный текстовый фильтр начинается с примеров, которые должны совпасть, и примеров, которые должны остаться вне результата. Проверьте обе группы, прежде чем применять шаблон к большому файлу.
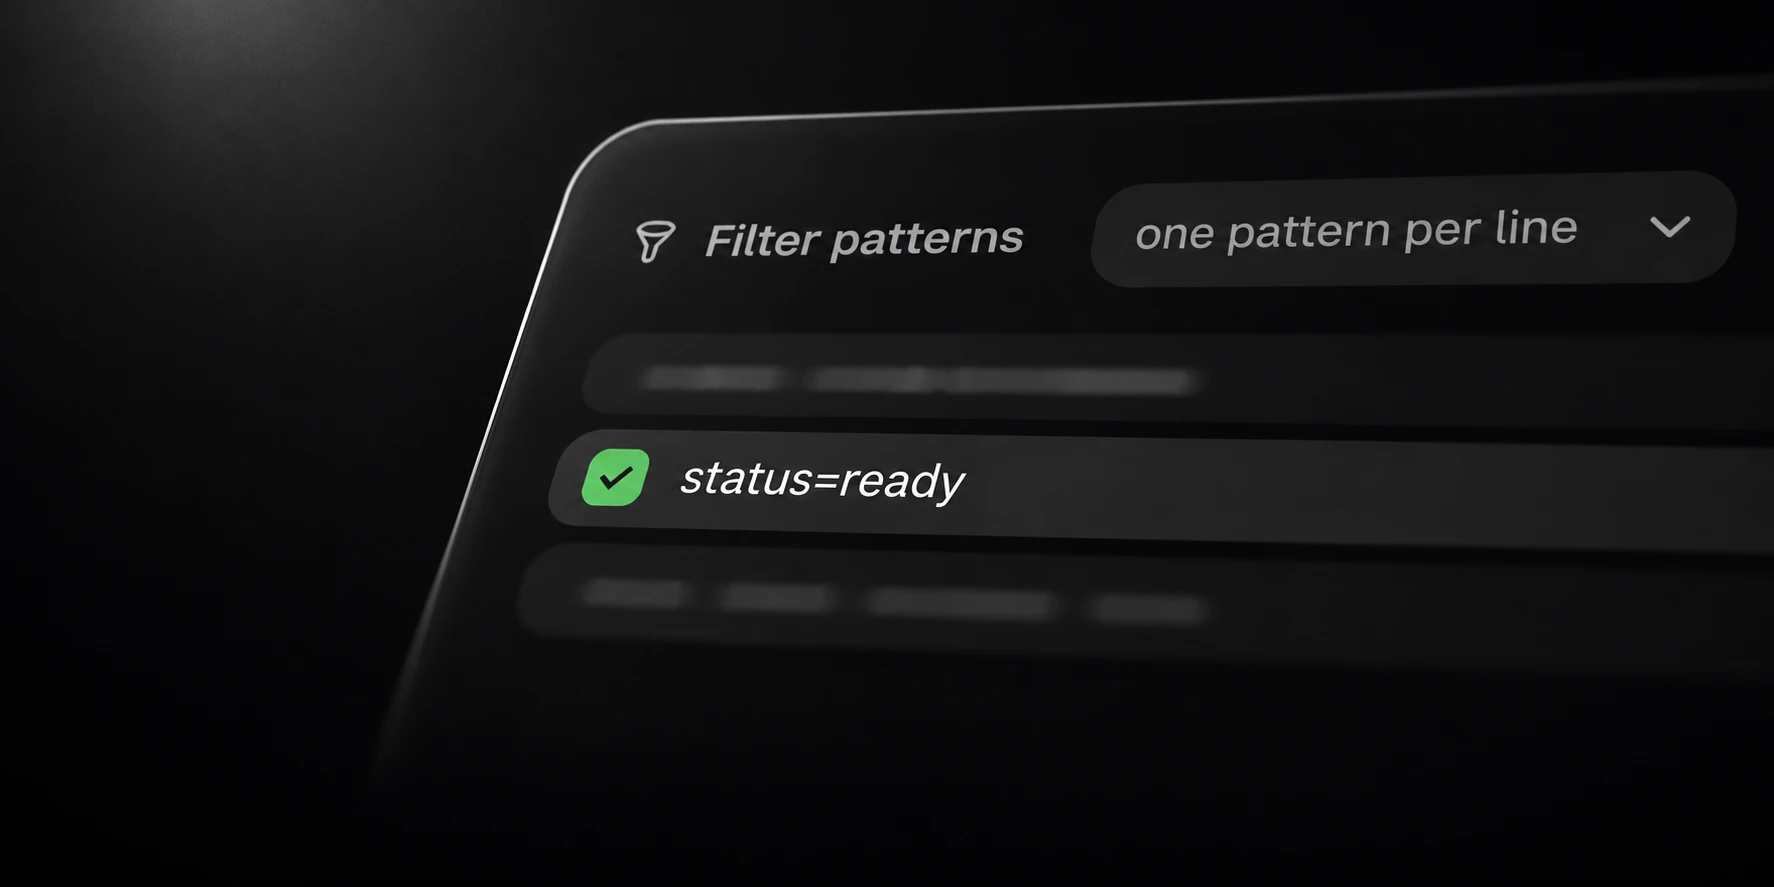
Filter в Sort поддерживает поиск обычной подстроки или регулярное выражение. По умолчанию используется обычный поиск, инверсия выключена, а сохранение несовпавших строк включено.
Выберите буквальное совпадение или шаблон
Используйте обычную подстроку, если нужен определённый фрагмент текста в любом месте строки. Поиск подстроки сам по себе не является сравнением целого поля или всей строки.
Например, подстрока status=ready входит и в status=ready_later. Прежде чем принимать
правило, решите, должно ли более длинное значение попадать в результат.
Регулярные выражения позволяют описать более точную структуру. Их знаки препинания имеют специальный смысл, поэтому выражение из другой программы нужно проверить с поддерживаемым синтаксисом.
Инверсия меняет выбранную сторону правила совпадения. Явно запишите эту настройку: обычный и инвертированный запуск могут быть корректны, но давать разные результаты.
Проверьте совпадения и несовпадения
Этот искусственный пример показывает потенциально ошибочное совпадение подстроки:
job-1 status=ready
job-2 status=waiting
job-3 status=ready_later
Обычный поиск status=ready находит первую и третью строки. Если нужна только первая,
правило следует уточнить. Одно лишь уменьшение числа строк не покажет эту ошибку.
Добавьте некорректные строки, пустые поля и типичные длинные записи из тестовых данных без закрытой информации. Проверяйте сохранённые строки целиком, чтобы не принять частичное совпадение за нормализованную запись.
При регулярном выражении проверяйте и попадание положительного примера в выгрузку, и отсутствие в ней несовпавшей строки. Не меняйте несколько настроек одновременно.
Просмотрите обе группы результатов
Filter записывает выбранные строки в filtered.txt. При включённом сохранении несовпадений
другая группа доступна в unmatched.txt. Во время оценки сохраняйте обе.
Отключение сохранения несовпадений меняет записываемый файл. Оно не убирает счётчики классификации и не меняет смысл выбранного правила.
Фильтр сам по себе не проверяет доступ к аккаунту, не исправляет данные и не доказывает смысловую правильность каждой выбранной строки. Используйте совпадение для определённой задачи.
После завершения операции сопоставьте выбранные и невыбранные строки с объёмом входных данных. При прерывании сохраняйте состояние завершения, чтобы непроверенный остаток был понятен.
Если результат всё ещё слишком велик для следующей программы, Splitter создаст меньшие части. Если следующему этапу нужны уникальные строки, отдельно используйте Deduper.