Elimina líneas duplicadas de archivos de texto grandes
Elige las reglas, comprueba una muestra pequeña y elimina duplicados de archivos de texto locales grandes con Sort.
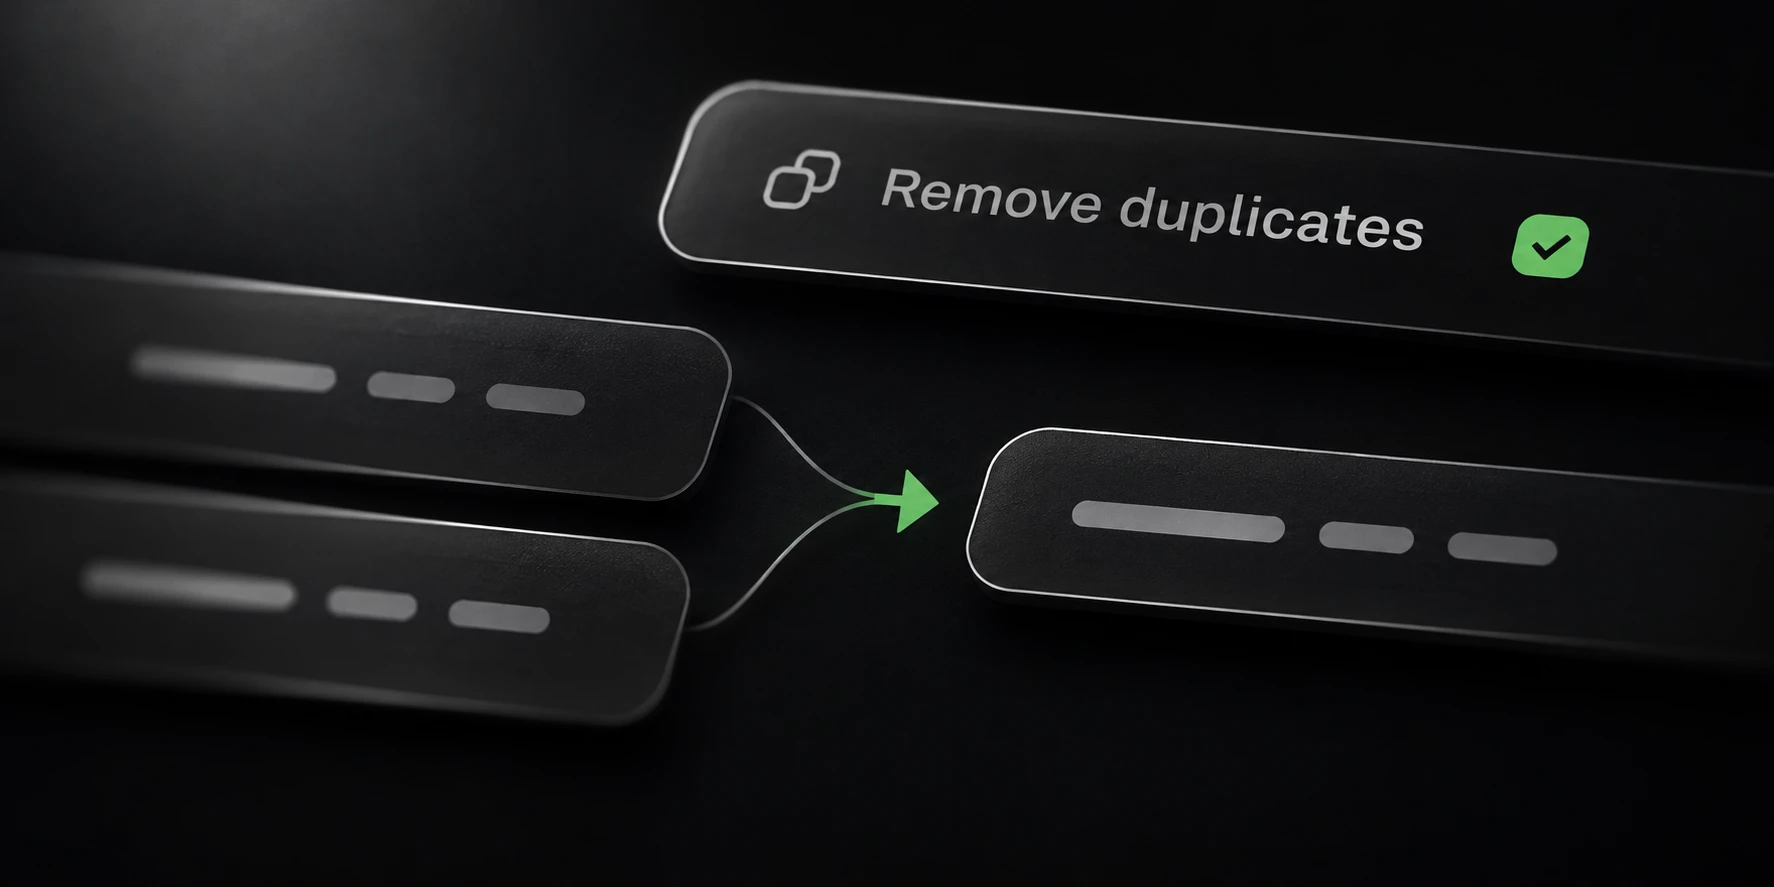
Eliminar líneas duplicadas de un archivo grande empieza por definir qué es un duplicado. Dos filas pueden parecer iguales en un editor y diferir en mayúsculas, espacios u otros bytes. Decide qué diferencias importan antes de aplicar la misma regla a una entrada mucho mayor.
Deduper de Sort lee archivos locales y escribe un resultado separado. Resulta útil cuando abrir todo el conjunto de datos en un editor es poco práctico. El contenido de entrada no se sube.
Elige qué se considera un duplicado
Deduper distingue mayúsculas y minúsculas por defecto. Es una decisión sobre los datos: ese cambio puede ser significativo en algunos registros. No ignores las mayúsculas solo porque se obtengan menos filas.
Estas filas ilustrativas contienen un duplicado exacto:
[email protected]
[email protected]
[email protected]
[email protected]
Si se distinguen mayúsculas y minúsculas, quedan tres filas distintas. Una comparación que no las distinga trata las dos formas de alpha como el mismo valor. La muestra ilustra reglas de igualdad; no es una prueba de rendimiento ni una promesa sobre el orden de todos los módulos.
Eliminar duplicados no valida el significado de una fila. No demuestra que una cuenta de correo funcione, que una URL sea accesible ni que un registro sea correcto. Utiliza el módulo que responda a la pregunta que realmente necesitas resolver.
Verifica una muestra pequeña
Crea un archivo pequeño con repeticiones exactas, variantes de mayúsculas y filas largas representativas de tus datos. Añade filas que deban mantenerse distintas. Conserva el original para poder comprobar el resultado esperado de forma independiente.
Abre Deduper, selecciona la entrada y una carpeta de salida local y revisa las opciones de duplicados. Ejecuta primero la muestra. Comprueba las filas guardadas y no te bases solo en que el contador de la interfaz haya disminuido.
Si también necesitas transformar registros, comprueba por separado el comportamiento de Cleaner o URL Cleaner. Normalizar una fila cambia lo que se compara. Para texto arbitrario, no supongas que una regla de limpieza específica para credenciales sirve como transformación general.
Ejecuta y revisa la salida
Selecciona la entrada completa cuando la muestra se comporte como esperabas. Deja espacio local suficiente para la entrada, el estado de procesamiento y la salida. Influyen el tamaño, las filas únicas, su longitud, la velocidad de almacenamiento y los ajustes; los bytes por sí solos no determinan cuánto tardará.
Deduper guarda deduped.txt en la ubicación elegida. Revisa una muestra de las filas y concilia
los recuentos con la operación terminada. Una ejecución interrumpida es trabajo parcial; conserva
esa distinción al planificar una continuación.
Si necesitas combinar varios archivos solapados en una operación, Joiner puede unirlos con la deduplicación activada. Su flujo se explica en la guía relacionada. La referencia de módulos que aparece más abajo enumera las demás herramientas y sus archivos de salida.
Conserva la salida aceptada y el origen hasta completar las comprobaciones posteriores. Un archivo más pequeño solo es útil si sigue conteniendo las filas que querías preservar.