Filtra archivos de texto grandes con texto literal o expresiones regulares
Elige una regla, prueba ejemplos positivos y negativos y revisa las filas coincidentes y no coincidentes.
Un filtro de texto útil empieza por ejemplos que deben coincidir y otros que deben quedar fuera. Prueba ambos grupos antes de aplicar un patrón a un archivo grande.
Filter de Sort admite coincidencias por subcadena literal o por expresión regular. De forma predeterminada utiliza coincidencia literal, con inversión desactivada y salida de no coincidentes activada.
Elige coincidencia literal o por patrones
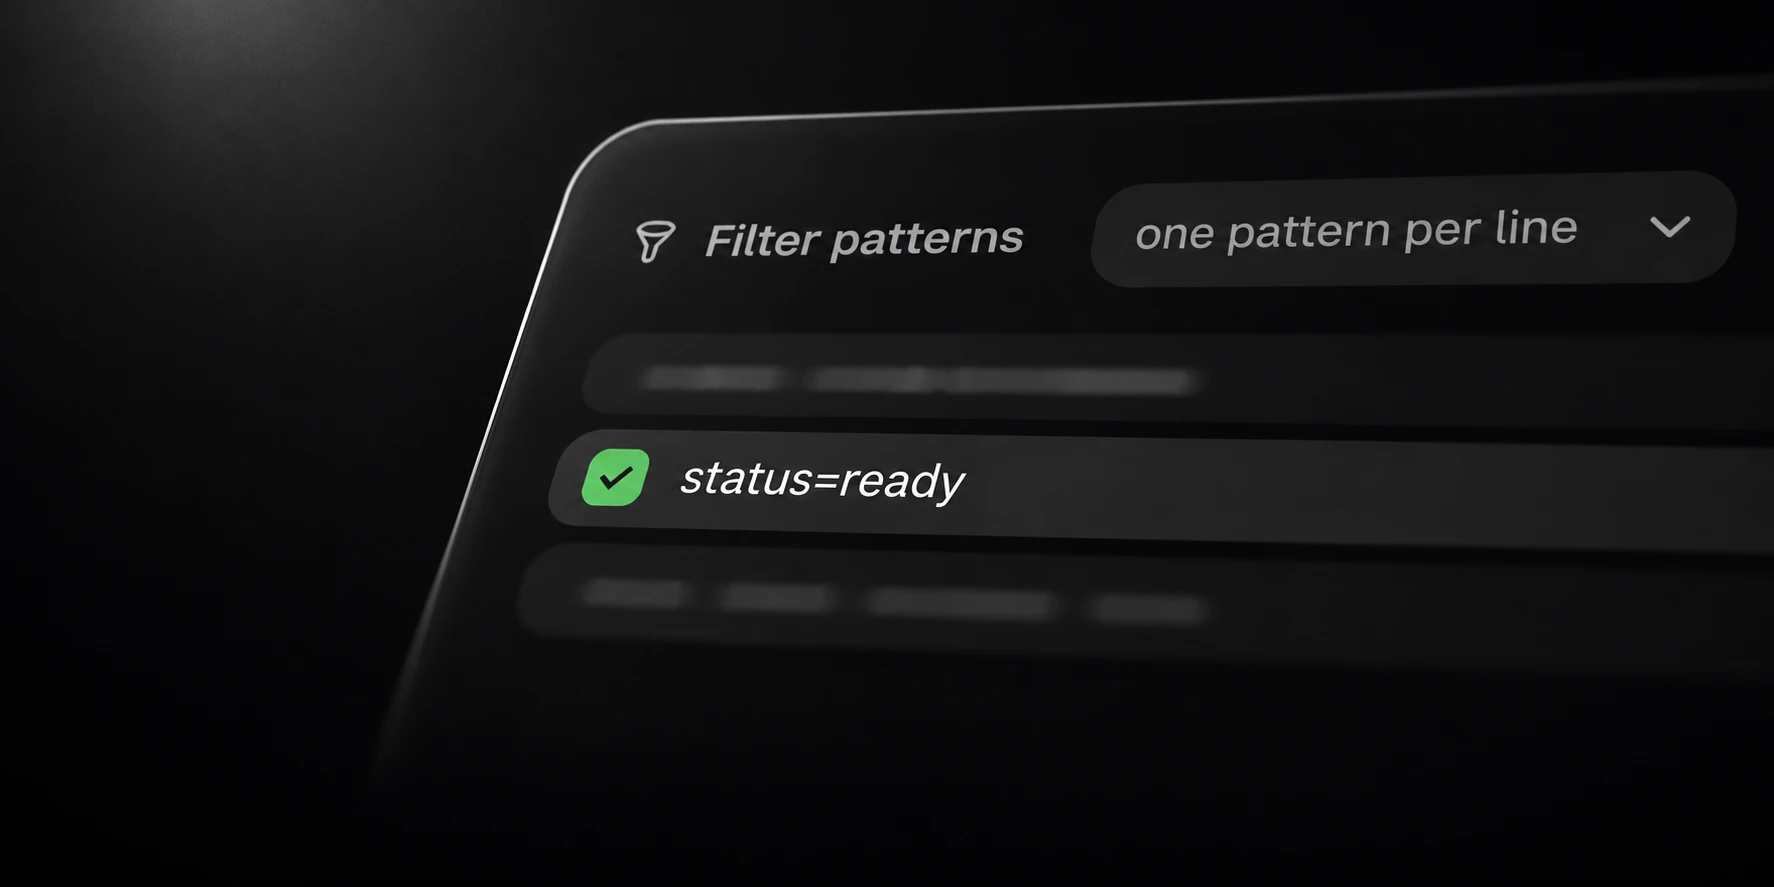
Utiliza una subcadena literal si buscas un fragmento de texto en cualquier parte de una fila. Una subcadena no equivale automáticamente a comparar un campo o una fila completos.
Por ejemplo, la subcadena literal status=ready también aparece en status=ready_later.
Decide si ese valor más largo debe incluirse antes de aceptar la regla.
Las expresiones regulares permiten describir estructuras más concretas. Sus signos tienen significado, por lo que una expresión copiada de otra herramienta necesita una prueba controlada con la sintaxis admitida.
La inversión cambia qué lado de la regla se selecciona. Registra ese ajuste explícitamente; una ejecución normal y una invertida pueden ser correctas y producir salidas diferentes.
Prueba coincidencias y no coincidencias
Esta muestra sintética permite ver una subcadena que podría inducir a error:
job-1 status=ready
job-2 status=waiting
job-3 status=ready_later
La búsqueda literal status=ready coincide con la primera y la tercera fila. Si solo querías la
primera, debes precisar la regla. Una reducción del recuento no revelaría por sí sola el error.
Añade registros mal formados, con campos vacíos y largos, procedentes de datos de prueba no sensibles. Revisa las filas guardadas completas para no confundir una coincidencia que parece parcial con un registro normalizado.
Con una expresión regular, comprueba tanto que entre un ejemplo positivo como que quede fuera una fila que no deba coincidir. Evita cambiar varios ajustes a la vez.
Inspecciona los dos grupos de salida
Filter escribe las filas seleccionadas en filtered.txt. Si guardas las no coincidentes, el otro
grupo estará en unmatched.txt. Conserva ambos durante la evaluación.
Desactivar el guardado de no coincidentes cambia el archivo que se escribe. No elimina los recuentos de clasificaciones rechazadas ni cambia el significado de la regla seleccionada.
Un filtro no valida por sí solo el acceso a cuentas, repara datos ni demuestra que todas las filas seleccionadas sean correctas en cuanto a su significado. Utiliza el resultado para la tarea definida.
Si la operación termina, concilia las filas seleccionadas y no seleccionadas con la entrada. Conserva el estado cuando el procesamiento se interrumpa para que quede claro qué resta por tratar.
Si el resultado sigue siendo demasiado grande para otra aplicación, Splitter puede crear partes menores. Utiliza Deduper aparte si la siguiente tarea necesita filas únicas.