Удаление повторяющихся строк из больших текстовых файлов
Выберите правила дублей, проверьте небольшую выборку и удалите повторы из больших локальных текстовых файлов с помощью Sort.
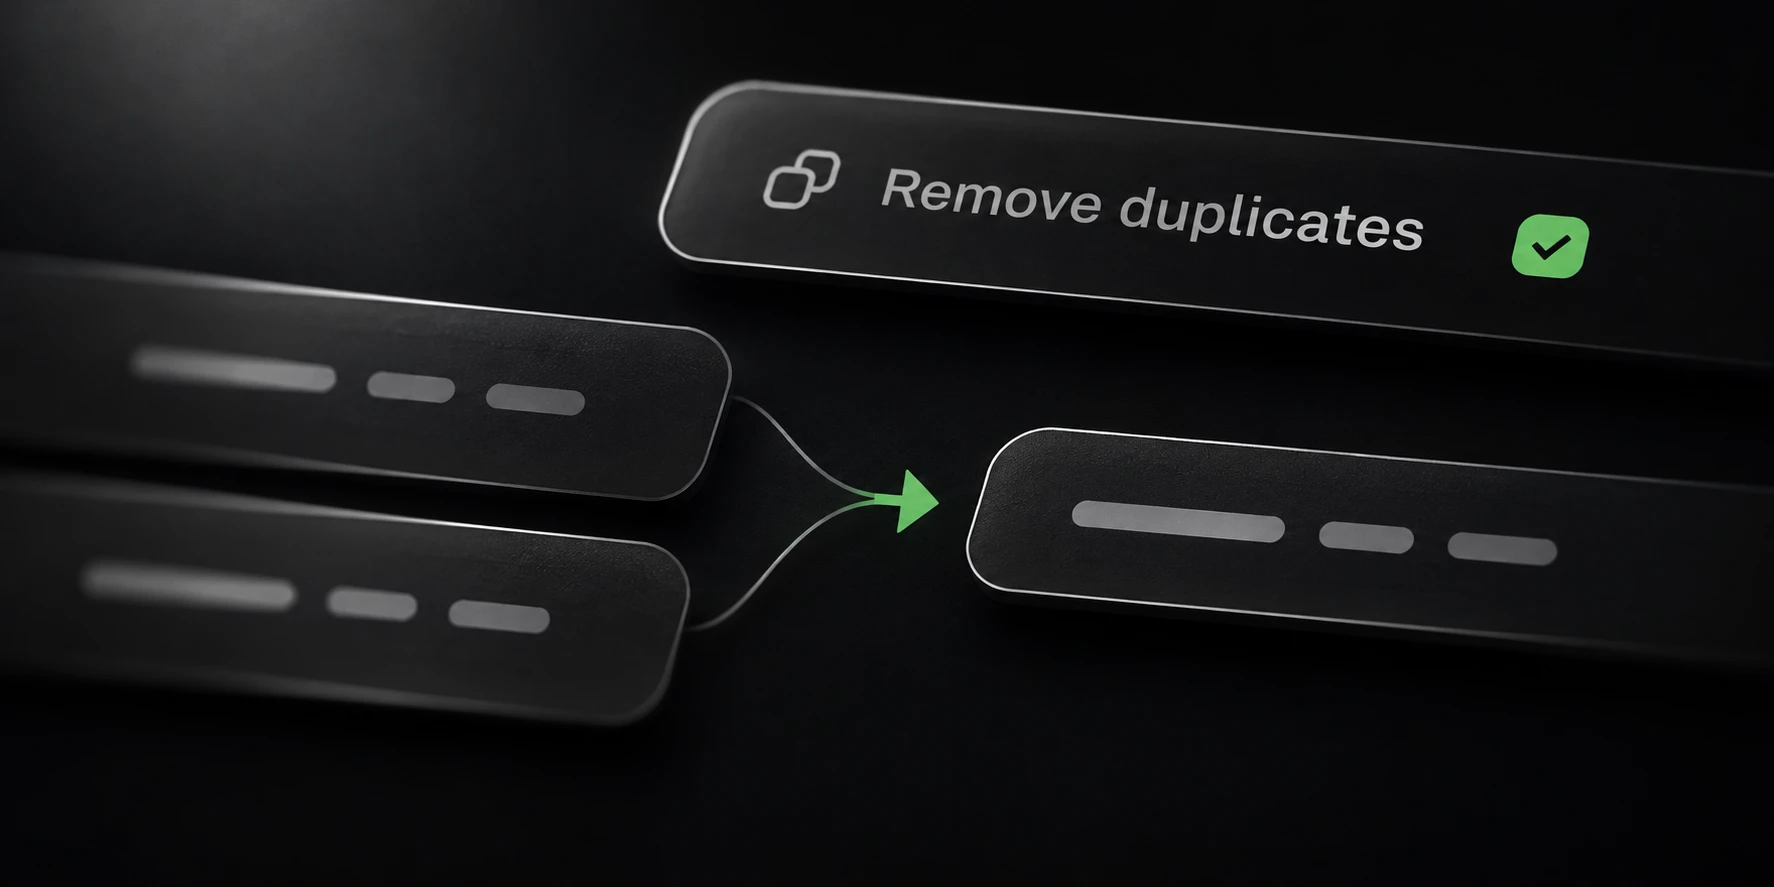
Удаление повторяющихся строк из большого файла начинается с определения дубля. Две записи могут выглядеть одинаково в редакторе, но различаться регистром, пробелами или другими байтами. Решите, какие различия важны, прежде чем применять правило к большому объёму.
Deduper в Sort читает локальные файлы и создаёт отдельный результат. Он полезен, когда весь набор данных неудобно открывать в редакторе. Содержимое входных файлов не загружается на сервер.
Определите, что считать дублем
По умолчанию Deduper учитывает регистр. Это решение о данных: в некоторых записях регистр имеет смысл. Не отключайте его учёт только ради уменьшения числа строк.
В этих условных строках есть один точный дубль:
[email protected]
[email protected]
[email protected]
[email protected]
При сравнении с учётом регистра останутся три различные строки. Сравнение без учёта регистра считает два написания alpha одним значением. Пример показывает правила равенства, а не скорость обработки и не обещание порядка для каждого модуля.
Удаление дублей не проверяет смысл строки. Оно не доказывает, что почтовый аккаунт работает, URL доступен или исходная запись верна. Используйте модуль, отвечающий на нужный вам вопрос.
Проверьте небольшую выборку
Создайте небольшой файл с точными повторами, вариантами регистра и типичными длинными строками из своих данных. Добавьте записи, которые должны остаться различными. Сохраните оригинал, чтобы ожидаемый результат можно было проверить независимо.
Откройте Deduper, выберите источник, локальную папку вывода и настройки сравнения дублей. Сначала запустите выборку. Проверяйте сами сохранённые строки, а не только уменьшившийся счётчик в интерфейсе.
Если нужно ещё и преобразование записей, отдельно проверьте Cleaner или URL Cleaner. Нормализация меняет сравниваемые данные. Для произвольного текста не считайте специальное правило очистки учётных данных универсальным преобразованием текста.
Запустите обработку и проверьте результат
Когда выборка даёт ожидаемый результат, выберите полный объём. Оставьте достаточно места для источников, состояния обработки и выгрузки. На запуск влияют размер файлов, число уникальных строк, длина записей, скорость накопителя и настройки; одни байты не определяют время.
Deduper сохраняет результат в deduped.txt в выбранной папке. Просмотрите выборку сохранённых
строк и сопоставьте счётчики с завершённой операцией. Прерванный запуск — частичная работа;
учитывайте это при планировании следующего этапа.
Если нужно объединить несколько пересекающихся файлов за одну операцию, используйте Joiner с удалением дублей. Его процесс описан в связанной статье. Справочник модулей ниже перечисляет остальные инструменты и их выходные файлы.
Сохраняйте принятый результат и исходник до завершения последующих проверок. Меньший файл полезен лишь тогда, когда нужные строки в нём сохранились.